Crawler AI: nel FTSE MIB quasi nessuno li blocca
Abbiamo letto il robots.txt delle 40 società del FTSE MIB: nessuna blocca GPTBot, una sola esclude ClaudeBot, nove hanno già un llms.txt. Dati e metodo.
Chi gestisce un sito prima o poi se lo chiede: i crawler dell'intelligenza artificiale vanno lasciati entrare o bloccati? Invece di rispondere con un'opinione, abbiamo guardato cosa hanno scritto nel robots.txt dei loro siti le 40 società del FTSE MIB, l'indice delle maggiori quotate di Piazza Affari.
Il risultato, al 29 settembre 2026: nessuna blocca GPTBot, nessuna blocca i crawler che servono alle risposte con ricerca, una sola esclude un crawler di addestramento. Dietro quel via libera, però, c'è meno decisione di quanto sembri.
Come abbiamo fatto la rilevazione
- Le società. L'elenco del FTSE MIB pubblicato da Borsa Italiana il 29 settembre 2026 e, per ognuna, il sito istituzionale indicato da Wikidata.
- Il file. Abbiamo scaricato il robots.txt di ogni sito lo stesso giorno e l'abbiamo letto con le regole dello standard RFC 9309: per ogni crawler vale il gruppo che lo nomina, e se nessuno lo nomina vale quello generale con l'asterisco.
- I crawler. Sedici nomi, presi dalla documentazione di OpenAI, Anthropic, Perplexity, Google, Apple, Common Crawl, Meta e Microsoft.
- Cosa conta come blocco. Un crawler è bloccato se non può leggere né la home né una pagina interna qualsiasi.
Il robots.txt è una richiesta, non un muro: dice cosa il sito vuole, non cosa succede davvero. Lo abbiamo letto come lo leggerebbe un crawler che rispetta lo standard, e basta.
Cosa abbiamo trovato
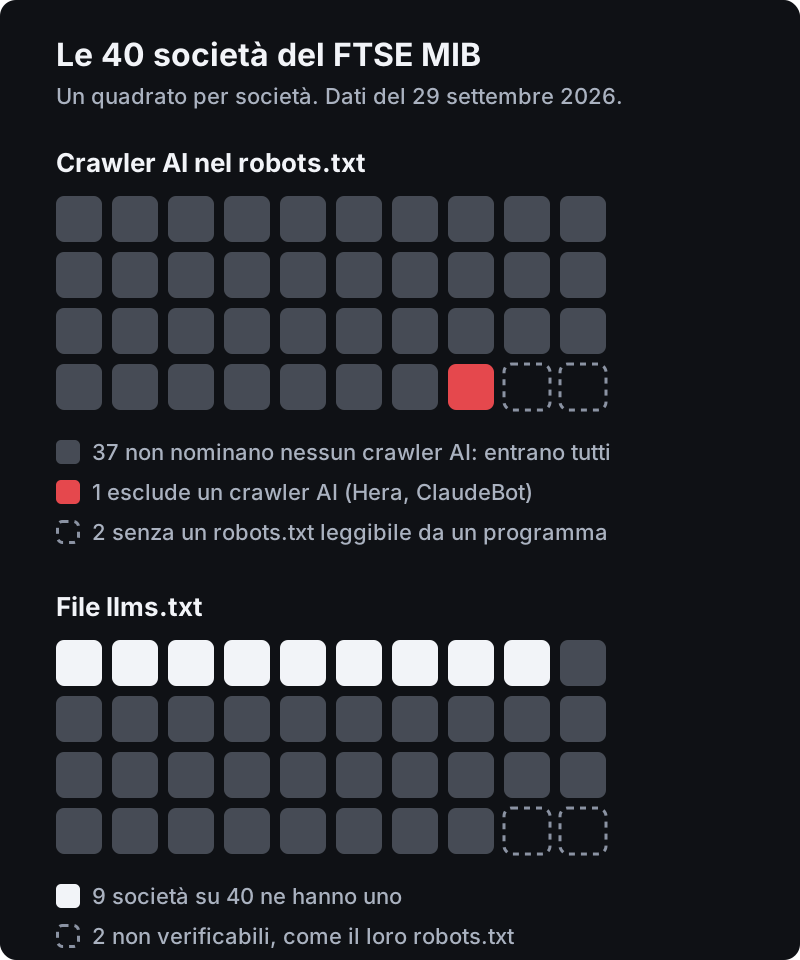
Dei 40 robots.txt, 38 si leggono: 37 esistono e uno manca del tutto, quello di Azimut, che per lo standard equivale a nessun limite. Gli altri due non si lasciano leggere da un programma, e ci torniamo sotto.
- GPTBot, il crawler con cui OpenAI raccoglie testi per addestrare i modelli: nessun blocco. Lo stesso per CCBot, il cui archivio pubblico serve anche a quello, e per il crawler di Meta.
- OAI-SearchBot, Claude-SearchBot e PerplexityBot, che servono alle risposte con ricerca: nessun blocco.
- Google-Extended e Applebot-Extended, i segnali con cui un sito dice a Google e ad Apple se usare i suoi contenuti per i loro modelli: nessun blocco.
- ClaudeBot, il crawler di addestramento di Anthropic: un blocco, di Hera.
Il dato che dice di più è un altro: 37 dei 38 file leggibili non nominano nessun crawler AI. Per loro decide la regola generale, spesso scritta prima che questi crawler esistessero. È un via libera, ma per inerzia.
Nove società su 40 hanno invece già un file llms.txt: Azimut, Brunello Cucinelli, Fincantieri, Generali, Intesa Sanpaolo, Inwit, STMicroelectronics, Technoprobe e UniCredit. In due casi la prima riga dice che l'ha generato un plugin, Yoast SEO: a volte arriva con un aggiornamento, non con una scelta.
Bloccare l'addestramento e bloccare la ricerca sono la stessa cosa?
Ogni azienda dell'AI usa crawler diversi per lavori diversi. OpenAI lo scrive nelle sue FAQ per chi pubblica: chi non vuole finire nell'addestramento blocca GPTBot, chi vuole comparire nelle risposte di ChatGPT con ricerca non deve bloccare OAI-SearchBot. Anthropic separa allo stesso modo ClaudeBot da Claude-SearchBot. C'è poi una terza famiglia, i programmi che aprono una pagina quando un utente lo chiede, come ChatGPT-User e Perplexity-User: i loro stessi fornitori avvertono che possono non seguire il robots.txt.
Google-Extended è un caso a parte. Non è un crawler ma un segnale, e Google precisa che non influisce sull'inclusione nella Ricerca né sul posizionamento: le AI Overview dipendono da Googlebot, come il resto dei risultati.
Quindi "bloccare l'AI" non è una scelta sola. Hera è l'unica ad averne scritta una: esclude ClaudeBot e lascia passare tutti gli altri, compreso il crawler di ricerca di Anthropic.
Quando il robots.txt non basta?
Alcuni dei casi più istruttivi non stanno nelle regole.
- Un filtro prima del file. Lottomatica, Moncler, Saipem, Stellantis e UniCredit hanno rifiutato con un errore 403 la nostra richiesta quando si presentava come un robot dichiarato, e l'hanno accettata quando si presentava come un browser. Lì c'è un filtro di rete sui programmi automatici: se un crawler AI passa lo decide quel filtro, non il robots.txt, e da fuori non si può sapere.
- Un file che non c'è. Il sito di Campari, al posto del robots.txt, risponde con la pagina di controllo di un servizio anti-bot: chi la supera, come un browser, trova un file che non blocca nessuno, ma un crawler che non esegue quel controllo non lo vede. Il sito corporate di Ferrari rimanda l'indirizzo del robots.txt a una pagina web; il file del sito principale, ferrari.com, non esclude nessun crawler AI.
- Una regola che si legge in due modi. A2A e BPER chiedono a bingbot, il crawler di Microsoft, solo di rallentare, con una riga Crawl-delay. Ma Crawl-delay non fa parte dello standard: per il parser di riferimento pubblicato da Google quel gruppo non si chiude lì, e il Disallow scritto subito sotto per Yandex e Baidu finisce per valere anche per bingbot. Bing riconosce Crawl-delay e con ogni probabilità legge il file come era stato pensato. Resta un file che due programmi leggono in due modi.
La lezione vale per qualsiasi sito: dopo aver toccato il robots.txt si controlla con il rapporto dedicato di Search Console e con lo strumento di Bing Webmaster Tools, non a occhio.
Cosa significa per una PMI?
Nei siti piccoli un blocco può non essere una scelta: capita che arrivi da un vecchio tema, da un plugin di sicurezza o da un fornitore prudente. Tre passi.
- Apri il tuo robots.txt, all'indirizzo tuosito.it/robots.txt, e cerca i nomi dei crawler. Se trovi un Disallow generale che non sai spiegare, chiedi chi l'ha messo e perché.
- Decidi per categoria, non in blocco. Se vuoi essere citato dagli assistenti, i crawler di ricerca devono poter entrare. Se non vuoi che i tuoi testi finiscano nell'addestramento, puoi escludere solo quelli.
- Ricontrolla ogni tanto. I nomi cambiano e ne arrivano di nuovi: una regola scritta due anni fa può non coprire i crawler di oggi.
Per chi vuole farsi trovare, il robots.txt è il primo passo di un lavoro più largo: come comparire su ChatGPT e negli assistenti AI. Un file llms.txt invece conta poco, come spieghiamo in llms.txt: cos'è e quando serve davvero. E per sapere se gli assistenti ti portano già visite, c'è la guida per trovarle in Google Analytics.
Un mese dopo, le agenzie digitali: stesso risultato
A ottobre 2026 abbiamo rifatto la stessa lettura su un campione diverso e più piccolo di dimensioni: 119 siti di agenzie e consulenti digitali italiani, 102 raggiungibili, presi dalle prime pagine di dodici ricerche con cui un'azienda cerca un fornitore.
| FTSE MIB (settembre) | Agenzie digitali (ottobre) | |
|---|---|---|
| Siti letti | 38 su 40 | 102 su 119 |
| Blocca almeno un crawler AI | 1 | 7 (7%) |
| Blocca tutti i crawler | 0 | 0 |
| Ha un llms.txt | 9 su 40 (23%) | 69 su 102 (68%) |
Il comportamento è lo stesso in due mondi molto diversi: il blocco dei crawler AI è raro e quasi sempre non deciso. Cambia solo il llms.txt, passato dal 23 al 68 per cento, e lì la crescita la spiegano i plugin SEO che lo generano da soli: in 25 dei 69 file la firma è dentro il testo.
Questi dati stanno in agenzie-web-italia-2026-10.csv, con il metodo nel README delle rilevazioni. Una differenza di metodo da sapere: sui siti delle agenzie la lettura è automatica e conta come blocco un Disallow: / nel gruppo che nomina il crawler, mentre sul FTSE MIB ogni file è stato letto anche a mano, caso per caso.
Domande frequenti
Le grandi aziende italiane bloccano i crawler AI?
No. Al 29 settembre 2026, sulle 40 società del FTSE MIB nessuna blocca GPTBot, nessuna blocca i crawler che servono alle risposte con ricerca, e una sola, Hera, esclude un crawler di addestramento, ClaudeBot. Il dato che dice di più è che 37 dei 38 file leggibili non nominano nessun crawler AI: il via libera nasce per inerzia, non per decisione.
Bloccare l'addestramento e bloccare la ricerca sono la stessa cosa?
No, e confonderli è l'errore più comune. Ogni azienda usa crawler diversi per lavori diversi: chi non vuole finire nell'addestramento blocca GPTBot, chi vuole comparire nelle risposte di ChatGPT con ricerca non deve bloccare OAI-SearchBot. Anthropic separa allo stesso modo ClaudeBot da Claude-SearchBot.
Il robots.txt basta a controllare i crawler AI?
No. In cinque casi su 40, cioè Lottomatica, Moncler, Saipem, Stellantis e UniCredit, un filtro di rete ha rifiutato con errore 403 le richieste che si presentavano come robot dichiarato, accettando quelle che si presentavano come browser. Lì chi passa lo decide quel filtro e non il file, e da fuori non si può sapere. Esistono anche programmi che aprono una pagina su richiesta di un utente e che, per ammissione dei loro fornitori, possono non seguire il robots.txt.
Cosa deve fare una PMI, in pratica?
Tre passi. Aprire tuosito.it/robots.txt e cercare i nomi dei crawler: un Disallow generale che nessuno sa spiegare va chiarito con chi l'ha scritto. Decidere per categoria e non in blocco, perché i crawler di ricerca servono per essere citati e quelli di addestramento sono un'altra scelta. Ricontrollare ogni tanto, perché i nomi cambiano e una regola di due anni fa può non coprire i crawler di oggi.
I dati
Il file completo, con una riga per società, una colonna per crawler e le note sui casi particolari, si scarica qui: dati dello studio in formato CSV. Si può riusare citando la fonte.
In sintesi
Al 29 settembre 2026 le grandi aziende italiane lasciano entrare i crawler dell'intelligenza artificiale: nessuna blocca quelli di ricerca e solo una esclude un crawler di addestramento. Ma quasi nessuna ha scritto una regola, e il via libera nasce da file che dell'AI non parlano. Per un'azienda più piccola l'indicazione è la stessa: decidere per categoria, scriverlo, e controllare che il file dica davvero quello che si voleva.